Domain chrp.de kaufen?
Wir ziehen mit dem Projekt
chrp.de um.
Sind Sie am Kauf der Domain
chrp.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain chrp.de kaufen?
Wie kann man eine Webseite effektiv verwalten, um die Benutzerfreundlichkeit zu verbessern und die Aktualität der Inhalte sicherzustellen?
1. Regelmäßige Überprüfung der Inhalte und Aktualisierung von veralteten Informationen. 2. Ein übersichtliches Layout und eine klare Navigation für eine benutzerfreundliche Erfahrung. 3. Einbindung von Feedback-Möglichkeiten für Nutzer, um Verbesserungsvorschläge zu erhalten. **
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Ähnliche Suchbegriffe für Informationsextraktion
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
Kermi Montageaufpreis für Sonderbohrungen - DienstleistungSpezialbohrungen Beim Einbau unserer Duschkabinen auf speziellen Fliesen wie Granit, Feinsteinzeug oder sonstigen harten Fliesenmaterialen ist ein erhöhter Zeitaufwand und Spezialwerkzeug notwendig.149,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **

Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
Kermi Aufpreis Sonderkonstruktion - DienstleistungDie Fakten - Maßanpassungen vor Ort – z. B. Zuschneiden von Profilen oder Glaselementen wegen schiefer Wände oder Sondermaßen - Sonderbefestigungen – Montage bei schwierigen Wandmaterialien (Naturstein, Porenbeton, Trockenbau mit Verstärkung etc.) - Individuelle Abdichtungslösungen – zusätzliche Silikonfugen, Spezialdichtprofile, Anpassungen bei unebenen Flächen - Anpassung an bauliche Besonderheiten – Dachschrägen, Vorsprünge, Nischen, Rohre, Fensterbänke - Zusatzkonstruktionen – Haltewinkel, Verstärkungsleisten oder Sonderhalterungen, die nicht im Standard-Montagesatz enthalten sind - Erhöhter Montageaufwand – deutlich längere Arbeitszeit wegen komplizierter Einbausituation99,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie kann man eine Webseite effektiv verwalten, um die Benutzerfreundlichkeit zu verbessern und die Aktualität der Inhalte sicherzustellen?
1. Regelmäßige Überprüfung der Inhalte und Aktualisierung von veralteten Informationen. 2. Ein übersichtliches Layout und eine klare Navigation für eine benutzerfreundliche Erfahrung. 3. Einbindung von Feedback-Möglichkeiten für Nutzer, um Verbesserungsvorschläge zu erhalten. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Ähnliche Suchbegriffe für Informationsextraktion
-
Kermi Montageaufpreis für Sonderbohrungen - DienstleistungSpezialbohrungen Beim Einbau unserer Duschkabinen auf speziellen Fliesen wie Granit, Feinsteinzeug oder sonstigen harten Fliesenmaterialen ist ein erhöhter Zeitaufwand und Spezialwerkzeug notwendig.149,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
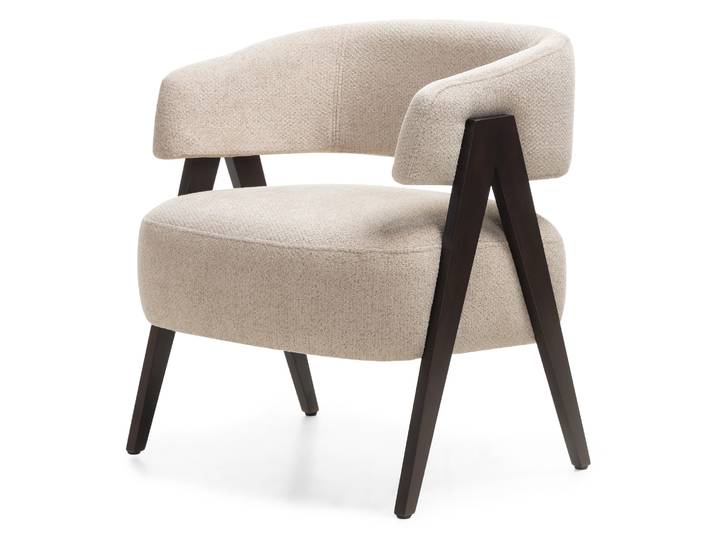
ANGEBOT Beige Design-Sessel MIZU II. QualitätANGEBOT Beige Design-Sessel MIZU II. Qualität. Material Bezugskomposition: 100% Polyester Bezugsstoff: Chenillestoff Bezug: ALIA 18 Abriebfestigkeit (Martindale): 50.000 Buchenholz: Walnussoptik Maße Breite: 64 cm Tiefe: 62 cm Höhe: 73 cm Sitzhöhe: 45 cm Sitztiefe: 52 cm Sitzbreite: 49 cm Produktdetails Design-Sessel im minimalistischen Stil Farbkombination im natürlichen Geist Bezug mit feiner Struktur und Melange von Farben Hydrophobe Behandlung des Bezugs und leichte Reinigung Beine aus massivem Buchenholz in Walnussoptik ALIA Der Bezugsstoff ALIA besticht durch sein elegantes Aussehen und seine feine Struktur, die sowohl visuell als auch haptisch angenehm wirken. Er wird aus zwei unterschiedlichen Garnsorten hergestellt – einem dominanten, weichen Chenillegarn und einem ergänzenden Garn mit feinerer Webart. Diese Kombination erzeugt einen dezenten plastischen Effekt und eine natürliche Farbtiefe. Der Stoff besteht aus 100% Polyester und bietet ein Gewicht von 430 g/m², was ihn zur idealen Wahl für Polstermöbel macht. Zu den Hauptvorteilen des ALIA Stoffes gehört seine hohe Widerstandsfähigkeit gegen Abnutzung – laut Martindale-Test hält er 50.000 Zyklen stand, was seine lange Lebensdauer auch bei häufigem Gebrauch garantiert. Die hohe Qualität wird durch eine Farbkonstanz auf der Stufe 4 und eine Pillingbewertung ebenfalls von 4 ergänzt, wodurch der Stoff sein ursprüngliches Erscheinungsbild über lange Zeit beibehält. Farbe:Beige Material:Gepolstert196,70 €*Versand: 5,90 €Sichere Weiterleitung zum Anbieter
-
Auer:Zur Aktualität der Privatrechtsthe, Fachbücher von Marietta AuerZiel der vorliegenden Abhandlung ist es, Reinachs Hauptwerk einem breiteren Publikum vorzustellen und damit einen nach hier vertretener Ansicht überfälligen Beitrag zu seiner Wiederentdeckung zu leisten. Dazu führt die Abhandlung zunächst in Reinachs Rechtsphänomenologie ein und weist Wege zu einer Reinach-Rezeption, die von phänomenologischen Denkvoraussetzungen weitgehend unabhängig sind. Die nachfolgenden Kapitel entfalten drei zentrale Grundbegriffe, auf denen das Gebäude von Reinachs Rechtstheorie aufruht: Versprechen als Grundbegriff des Schuldrechts, Gehören als Grundlage des Sachenrechts sowie Bestimmen als Ausgangspunkt der gesamten positiven Rechtsordnung. Das abschliessende Kapitel ordnet diese Erkenntnis in den Kontext alternativer rechtstheoretischer Entwürfe ein und fragt nach der Fruchtbarkeit einer heutigen Beschäftigung mit Reinachs Theorie. Das Ziel der Abhandlung ist erreicht, wenn es gelingt, die Brauchbarkeit von Reinachs sprachphänomenologischem Ansatz im Zusammenhang aktueller Privatrechtsdebatten zu erweisen. Das Thema der vorliegenden Abhandlung könnte daher kurz zusammengefasst auch lauten: Versprechen, Gehören, Bestimmen - Privatrecht erklärt durch drei performative Verben.29,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
-
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.